Gridline Arcade
实时双人游戏平台,包括四子棋、终极井字棋及策略变体。
进入游戏 ↗01 / 项目
实时双人游戏平台,包括四子棋、终极井字棋及策略变体。
进入游戏 ↗一个交互式模态逻辑工具。你可以搭建可能世界模型,改变世界之间的可达关系,再用反模型检验公式在不同系统中的有效性。
打开 Logic Lab ↗我设计情境选择题、Prompt Builder 和新玩家首战流程,参与前端设计与调试。
我也访谈用户、设计人工测试体系,并参与同步评审和模型推理链(CoT)的审查。为了检验 AI 裁判的可靠性,我设计并运行基准测试,观察裁判的偏差,以及改变输入后判决有多敏感。
02 / 文章与 FOUNDATIONS
我对心灵、语言和数学哲学感兴趣,也担任中学生哲学大会华北地区组委。这里收录三篇 Foundations 预印本和我的一篇竞赛论文。
心灵哲学
探讨第一人称体验能否作为第三人称科学解释中的变量。
阅读预印本 ↗语言哲学与科学哲学
用沙堆悖论区分我们对微小变化的容忍与「一堆」的真假条件,并探讨物理结构能否确定边界。
阅读预印本 ↗逻辑与数学哲学
区分不完备定理本身的结论,以及要将其用于心智、数学实在或知识问题时需要补充的前提。
阅读预印本 ↗2026 John Locke 论文竞赛 · 哲学组 Commendation
我的参赛论文区分两种安慰:一种来自获得答案,另一种来自重新审视为什么自己非要得到答案。
阅读论文(PDF)↗03 / 目前在做
我以前总想先从原理上说清楚一个方法为什么有效。训练 mini-GPT 时,我看到验证损失在降,模型的续写却还会前后矛盾。我先怀疑的是数据:我拿什么来测,又希望这个数字替我说明什么?
后来做短答案微调,模型做对了部分复制和抽取题,却在八道是非推断题里都以 Yes 开头,四道正确答案是 No 的题全部答错。我原先没想到它会以这种方式失败。现在,我更愿意先用一个小实验试试自己的直觉,再根据结果改写问题和解释。
在 N1,我从手写 BPE 分词器和 TinyStories 上的小模型对照做起,后来用 FineWeb-Edu 的 60 亿 token 预训练了一个 4.08 亿参数的模型,并用固定题目比较不同微调方案的表现。
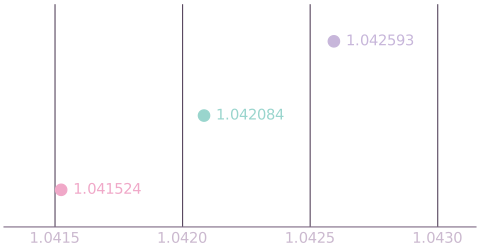
在 TinyStories 上用约 1456 万参数的小模型比较固定频率和可学习的旋转位置编码。确认实验对每个方案使用三个随机种子。
| 方案 | 平均 NLL |
|---|---|
| 固定 RoPE | 1.042593 |
| 共享可学习对数频率 | 1.042084 |
| 随机初始化、逐层可学习频率 | 1.041524 |
随机逐层方案比固定基线平均低约 0.10%,在三个种子中胜出两次。这是单一数据集和模型规模下的小幅差异。
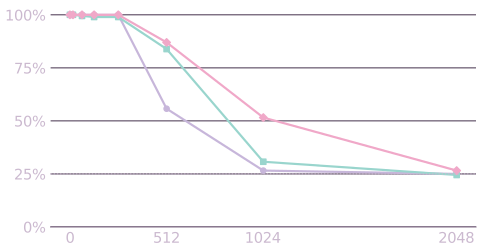
在探索性的四选一单事实检索中,插入 512 个 token 后,随机逐层方案的平均准确率为 86.98%,固定基线为 55.73%。插入 2,048 个 token 后,各方案接近随机猜测水平。
固定 RoPE共享可学习对数频率随机逐层
04 / 荣誉
05 / 教育经历
06 / 联系方式